作者:YJango
大家选择这门课,显然是为了提升认知或思维能力、提升学习能力的。但你有没有想过,什么是认知、如何描述思维过程?
如果我们连思维过程都无法描述,不知道这个过程在做什么、需要什么,又何谈提升呢?
许多人喜欢听知识付费内容,很多人已经坚持了3到5年,但大多数人都无法描述自己这些年学了什么。
如果我们无法描述知识,就无法判断自己学了什么,也不知道该何时应用所学知识,更谈不上提升学习能力了。
所以,接下来,我们就要讲解,如何描述「思维过程」「知识」以及「知识的适用范围」。
在异星求生的故事中,你可以直接感知到暗霞的相关信息(弦、环),而你需要知道的是触碰后手心数值变化的信息(升或降、具体数值)。于是,你用「暗霞的相关信息」去预测「触碰后手心变化的信息」。
打出租车时,我们可以查到「距离」「起步价」「每公里计价」等信息,而我们需要知道的是「总价」。于是,我们常会用「距离」「起步价」「每公里计价」等信息去推测「总价」。
打羽毛球时,我们可以观测到「对手的动作」和「球的位置」等信息,而大脑需要知道的是「控制各个肌肉进行反击的神经信号」(一种内隐信息)。于是,大脑会用「对手的动作」和「球的位置」等信息去推测「反击的神经信号」。
从上面的例子中可以发现一个共性,它们都是「从一堆信息推测另一堆信息」的「思维过程」。
若从「过程视角」来看,这种思维过程该被称为"信息加工"或"输入推测输出",因为「过程视角」强调「加工」,不强调「加工前的信息」和「加工后的信息」有什么作用和目的。
若从「功能视角」来看,这种思维过程该被称为"信息推测"或"已知推测未知",因为「功能视角」强调作用和目的,会将「加工前的信息」视为「推测根据」,而将「加工后的信息」视为「推测目标」。
两种视角下的称呼都可以,但本课程强调目的,因此采用"信息推测"的名称。
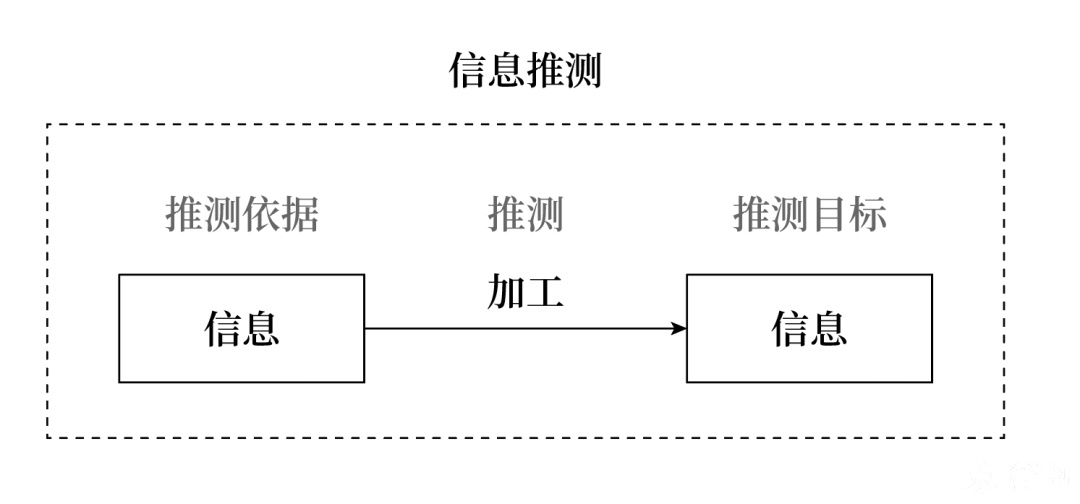
「信息推测」是人类最基础的思维过程。在这里,"基础"的意思并不是「低端」,而是「不可再分」。换句话说,高级思维过程可以被分解为「信息推测」的组合。
之前我们提到的「预测」实际上就是「推测」的一种形式。不同之处在于,「预测」是「从当下推测未来」,而「推测」的外延更广,不仅可以「从当下推测未来」,还可以是(但不限于):
「信息推测」时刻发生。想象你看到「一个双手掩面的人」,你的大脑并不会停留在这个画面,而是会不自觉地推测「此人可能正在哭泣」、推测「此人经历了什么」、推测「此人的内心活动」等。正是通过这些推测,我们的思维才得以形成一个「完整连续的世界」,而非「零碎离散的瞬间」。
「信息推测」也分为「经验推测」和「模型推测」。
虽然我们只讲过「经验预测」和「模型预测」。但只要将二者扩展一下,去掉「从当下推测未来」的限制,就可以直接推广到「经验推测」和「模型推测」。
对「信息推测」有了基础认识后,接下来,我们将像第六集介绍判别模型时那样,对「信息推测的构成」进行更详尽地讲解。毕竟 "从一堆信息推测另一堆信息" 的表述,只是一种简略说法,缺失很多细节,容易让读者以为自己理解了,但实际难以应用。这一次,我们将运用数学概念来描述「信息推测」。
但在开始之前,有两个误区需要提醒大家注意:
首先,在这里,数学概念是我们用来分析和描述「思维过程」的一个「工具」,并不是说「思维过程」在本体上等同于「数学」。
之所以要提醒大家这一点,是因为生活中经常能听到诸如"X不过是数学/统计学"的言论。这其实也是「类别固有观」的一种表现,因为说话人把「"X是Y"的句式」解读成了「X在物质世界中的本体是Y」。"不过是"这个选词,也反映了说话人在得知X只是数学后,感叹自己此前高估了X的本体。
实际上,汉语中的"是"有两种含义:一个是「经验推测下的"是"」,即「等同于」,另一个是「模型推测下的"是"」,即「被归于」。
当 X 和 Y 的抽象层级没有差异时,「"X是Y"句式」中的「是」意为「等同于」。
当 X 和 Y 的抽象层级一低一高时,「"X是Y"句式」中的「是」意为「被归于」,也就是「将 X 归类于 Y」,暗示着「我们接下来将用 Y 的处理方式来处理 X」。
举例说明,"王阳明是王守仁"、"水的化学式是",都是「等同于」。
但"苏格拉底是哲学家"中的"是",并非在说,"苏格拉底" 在本体上与 "哲学家" 这一概念等同,而是说,我们暂时剥离"苏格拉底"的部分属性,将其归于 "哲学家" 这个概念,并按照「"哲学家"的通用处理方式」来分析和描述"苏格拉底"。
同理,当我们用数学概念来介绍「思维过程」,意味着我们将按照「数学概念的通用处理方式」来分析和描述「思维过程」,并不是在宣称,「思维过程」在本体上等同于数学。
第二点误区,很多人一听到数学,就会下意识联想到复杂的公式和头疼的计算。但其实,数学就像汉语,本质上是一种用来「描述世界的语言」。数学最强之处不在于计算,而是允许我们用数学概念更清晰地描述现实。"信息推测" 和 "输入推测输出" 这两个名称,其实刚好就反映了两种语言的描述,"信息推测" 更接近我们日常使用的自然语言,而 "输入推测输出" 更贴近数学语言的表达。
在这门课程中,不会涉及复杂的公式和计算。你需要做的,是建构出课程所介绍的数学概念。一旦你能够像语文课上"造句"那样,用这些数学概念来描述(编码)周围的思维过程和学习现象,这就意味着你已经掌握了它们。
能用来描述思维过程的数学概念有很多,为了照顾大多数人,课程尽量避免引入过多的数学概念,并且选用人们熟悉的数学概念进行描述。
在引入数学概念进行描述时,课程会先用我们日常语言(也叫自然语言)来描述,随后介绍相应的数学描述,并解释为何选择这种数学描述。
「信息推测」的日常描述是"从一堆信息推测另一堆信息" 或 "从已知推测未知" 。若用数学语言来描述,则是"从输入到输出的单向关系"。
数学之所以这样描述,是因为:「信息推测」具有方向性,而「输入」和「输出」分别意味着「关系的起点」和「关系的终点」,刚好适合表达「信息推测」中的「推测依据」(输入)和「推测目标」(输出)。
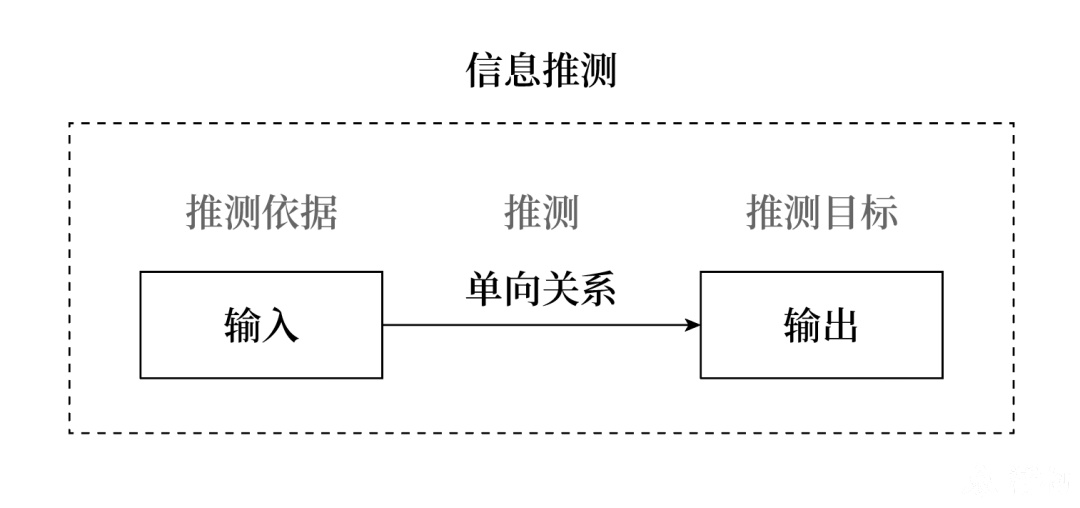
一些人首次接触"输入"和"输出"这两个名词是在机器学习领域,因此可能对它们有一种"机械"的印象。但实际上,「输入」「输出」并不是机器学习或工程领域的专有词汇,而是「数学概念」,所有学科中都有使用,例如,心理学、经济学、社会学。因为任何学科都需要描述「状态」与「变化」,而「输入」与「输出」就是描述「变化前状态」与「变化后状态」的数学语言。
「输入」和「输出」其实在初高数学中就有教,同函数一起出现的自变量和因变量就是输入和输出的一种。
「输入和输出」本质上是一种"状态",而「(二者的)关系」本质上是一种"变化/运动"。
但要注意:但这里的"状态"和"变化/运动"并不是「内容上的」,而是「形式上的」。即使一个东西,在「内容上」属于一种变化/动作,我们也可以不将其按照「关系」来处理,而按照「输入和输出」来处理,只要我们将它转换成「输入和输出」的形式。
这也意味着:一个东西能否作为输入或输出,并不是客观的,而是人主观选择的。
这就像「英语中的词性」。虽然「游泳」这个概念,在内容上,属于一种动作,但我们也可以不将其按照「动词"swim"」来处理,而按照「名词"swimming"」来处理,只要我们将它变成「形式上的名词」即可。然后我们就可以套用「"Swimming is a popular sport" 这个名词的句式」。
再举一个实际例子。
从「光的传播时间」推测「光的传播距离」时,会得到二者的关系,姑且称为"关系A"。
此时,「光的传播时间」是输入,「光的传播距离」是输出,而「关系A」既不是输入,也不是输出。
但是,在另一个推测中,我们其实可以把「关系A」视为「输入」去推测「是否可导」和「是否连续」。
熟悉编程的人更容易理解这一点。在编程中,函数是输入和输出之间的关系,但函数也可以作为输入传递给另一个函数。
对于输入和输出的数量,一定有人会好奇,如果遇到「从多个输入向多个输出的推测」,该如何描述呢?
其实,只需要引入「维度」这个数学概念,就可以避免使用「多个输入」的说法。因为无论有多少个"输入",都可以视为「一个输入的不同维度」。「输出」也可以按这个逻辑处理。换句话说,我们将「输入」或「输出」看作「一个多维向量」而不是「多个单维标量」。
这样做的好处是:我们不必为不同数量的输入和输出建立不同的描述方式和公式,可以使用统一的描述方式来应对各种数量的情况。
其实,在自然语言中,「向量的维度」对应着「概念的子概念」。我们知道,任何概念都可以被拆分成多个概念,而多个概念也可以被划分为单一概念。所以,不论说"一个概念"还是"一堆概念"都没什么差别。但说"一个概念"会更加方便,之后可以在必要的时候,再把"一个概念"详细描述成"一堆概念"。
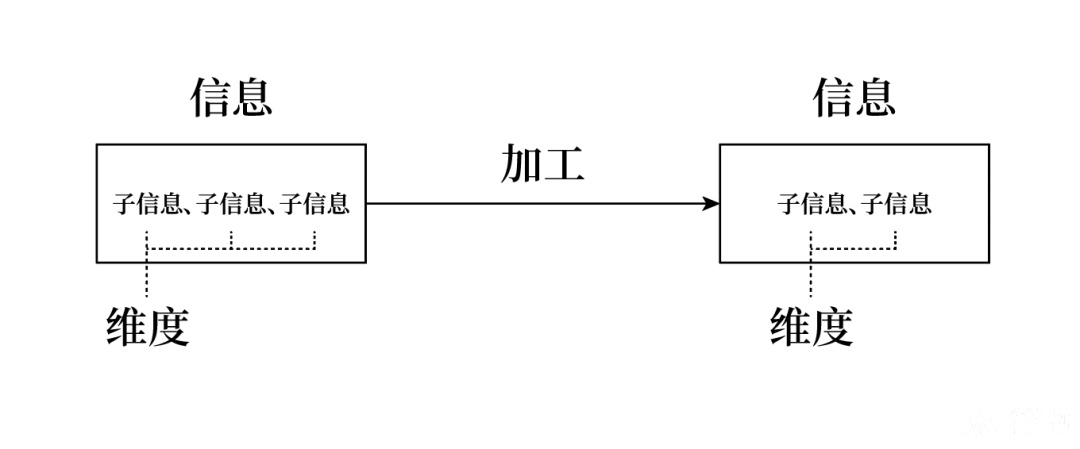
例如,在打羽毛球的例子中,我们可以将「对手的动作」和「球的位置」视为「一个输入的两个维度」,而不是两个独立的输入。同样地,「控制肌肉的神经信号」其实也有很多个,我们也可以将它们看作「一个输出的不同维度」。
又如,在从「暗霞」到「手心数值变化」的推测中,「暗霞」可以被视为一个输入,而「弦的数量」和「环的数量」则被视为「暗霞的两个维度」。同样地,「手心数值变化」也被我们视为一个输出,而「数值的变化」和「升降的变化」则是它的两个维度。
在从「拳击选手条件」到「比赛输赢」的推测中,「拳击选手条件」这一个输入,就可以包含「红方选手条件」和「蓝方选手条件」两个维度,而「红方选手条件」又可以被细分为「身高」「体重」「年龄」「历史战绩」等维度。同理,「比赛输赢」这一个输出,可以仅包含「优胜者是谁」这种单一维度,也可以包含「双方点数」「回合次数」等多维信息。
前面说过,「信息推测」可以细分为「经验推测」和「模型推测」两种类型。当进行「经验推测」时,「信息推测」的数学描述会变得更加具体:由"从输入到输出的关系"转变为"从「输入常量」到「输出常量」的「对应关系」"。
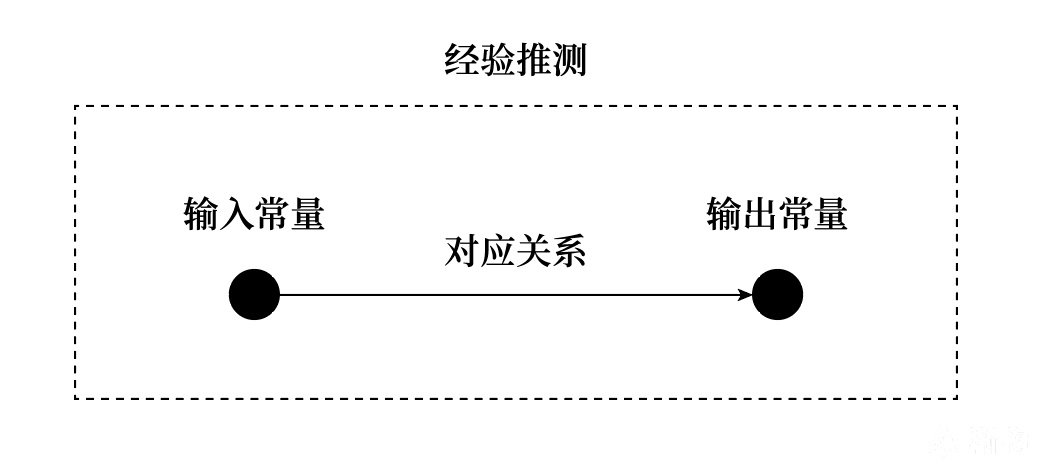
之所以用「常量」描述,是因为:「经验推测」中的「输入」「输出」都是「确定的唯一可能状态」,不像「模型推测」中的「输入」「输出」可以是「多个可能状态中的任意一个」。「常量」正是用于表达这种「确定的唯一可能状态」的特性。
注意,「常量」虽有一个"量"字,但它不必是「数字」,本质上是「状态」。
举例来说,当我们把「对象层」设为「具体数字所处的层面」时,"「3」-「1」=「2」"的关系中,「3」和「1」是「输入常量」,「2」是「输出常量」,因为「3」「1」「2」都是「确定的唯一可能状态」。
但是,在"「被减数」-「减数」=「差」"的关系中,「被减数」和「减数」不是输入常量,「差」也不是输出常量,而是「变量」,因为「被减数」「减数」「差」都可以代表1、2、1.2等「多个可能状态中的任意一个」,而非「确定的唯一可能状态」。
之所以用「对应关系」描述,是因为「经验推测」中「输入」「输出」的「关系」是「两个具有唯一可能状态的对象」之间的「直接对应」,不像「模型推测」中的「关系」是「两个可以有多个可能状态的概念」之间的「映射关系」。
在本课程中,「对应(关系)」专门被用来指代「一个常量和另一个常量之间的关系」。当出现"对应"一词时,也意味着我们将当前讨论的对象视为一个常量。
例如,"「这个苹果」是「酸的」"的关系中,「这个苹果」是「输入常量」,「酸的」是「输出常量」。「这个苹果」和「酸的」之间的关系就是「对应关系」,因为二者被我们视为常量,都是「具有唯一可能状态的对象」。
但是,"「苹果」是「可食用的」"的关系中,「苹果」可以代表红苹果、绿苹果、国光、红富士等多个可能状态,不是常量,而是变量,因此,「苹果」和「可食用的」之间的关系,就不是「对应关系」,而是「映射关系」。
「经验推测」中的「输入常量」「输出常量」「对应关系」就好比一个实心点(输入常量)与另一个实心点(输出常量)连成一条实线(对应关系)。
同样地,当进行「模型推测」时,「信息推测」的数学描述也会更加具体:由"从输入到输出的关系"转变为"从「输入变量」到「输出变量」的「映射关系」"或"从「输入空间」到「输出空间」的「映射关系」"。
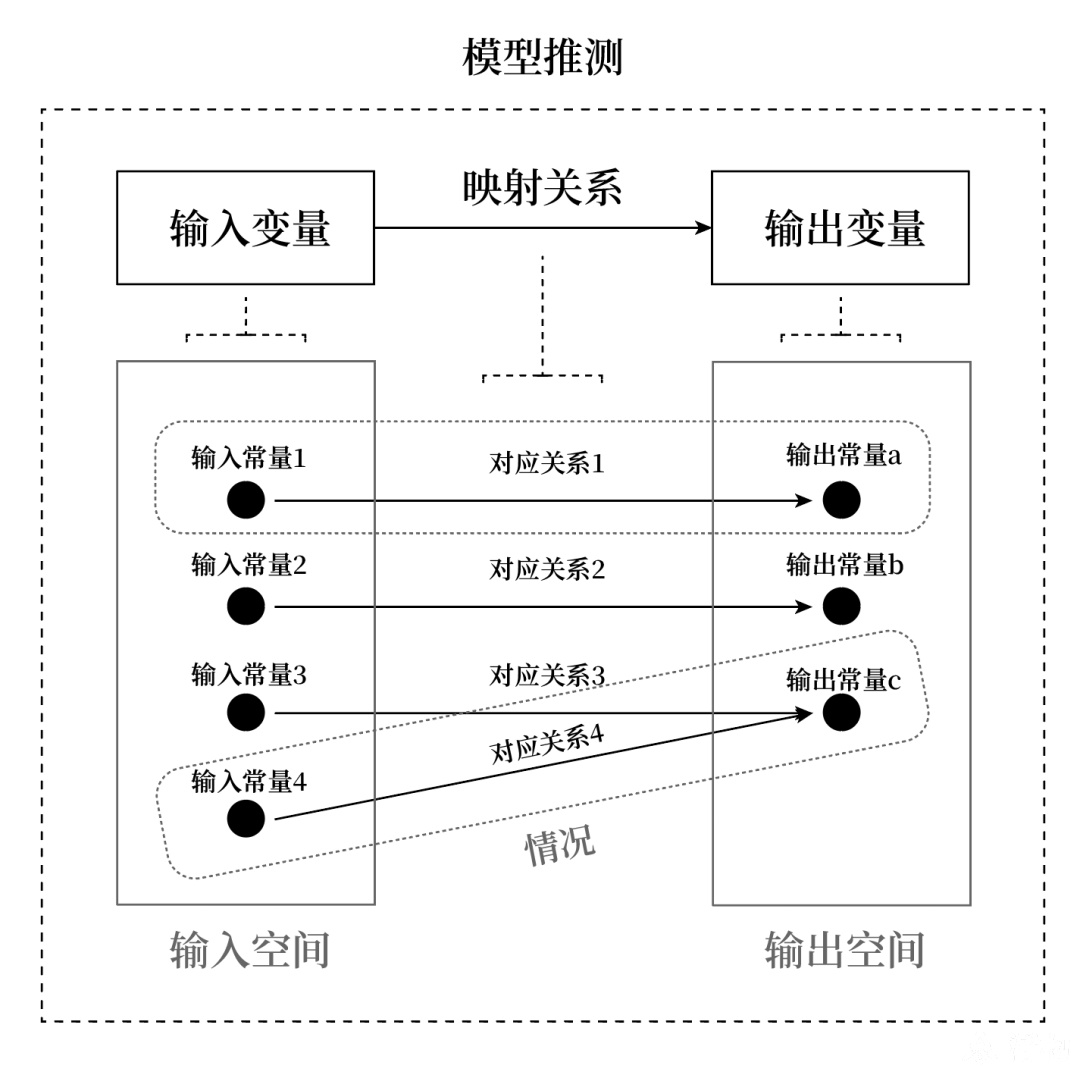
之所以用「变量」描述,是因为:「模型推测」中的「输入」「输出」并非「确定的唯一可能状态」,可以是「多个可能状态中的任意一个」,「变量」正是用于表达这种「可以在特定范围内任意取值」的特性。
例如,"从「溶液」到「酸碱性」"的推测中,作为「输入(推测依据)」的「溶液」,并非「确定的唯一可能状态」,而可以是「温泉水」「啤酒」「洗衣液」「氢氧化钠溶液」等「多个可能状态中的任意一个」,因此是「变量」。而作为「输出(推测目标)」的「酸碱性」也不是「唯一可能状态」,而可以是「酸性」「中性」「碱性」等「多个可能状态中的任意一个」,因此也是「变量」。
我们也使用「输入空间」和「输出空间」来描述「输入变量的可取值范围」和「输出变量的可取值范围」。
虽然一些人可能不熟悉「空间」这个数学概念,但高中教过「集合」,而「空间」实际上就是「满足特定性质的集合」。在这里,「变量」对应着自然语言中的「概念」,而「空间」对应着自然语言中的「概念的外延」,「空间里的元素」则又对应着自然语言中的「外延里的对象」。
「输入空间」和「输出空间」也有别名,分别叫做「定义域」和「到达域(陪域)」。注意与「值域」相区分,「输出的实际取值范围」是「值域」,但「输出空间」是「输出的可能取值范围」,因此不是「值域」,而是「到达域(陪域)」。
之所以我们描述「输出空间(到达域)」,而非「值域」,是因为在「信息推测」之前,我们只知道「可能取值范围」,并不知道「实际取值范围」。
例如,"从「人」到「寿命是否有限」"的推测中,「输入空间」是「所有具体的人(如嬴政、孔子)所组成的集合」,也就是「"人"这个概念」的外延,而「输出空间」是「"有限"和"无限"两个可能状态所组成的集合」,也就是「"是否有限"这个概念」的外延。
尽管通过归纳,我们得出"所有人的寿命都是有限的",即"「输出的实际取值范围」都是「有限」这一个可能状态",但在描述这个信息推测时,我们应该说"我们在探究「人」与「寿命是否有限」的关系",而不该说"我们在探究「人」与「寿命有限」的关系",因为后者只不过是探究的结果。这也是为什么我们要描述"「输入空间」和「输出空间」的关系",而不是描述"「输入空间」和「值域」的关系"。
至于「模型推测」中「输入(变量)」和「输出(变量)」的「关系」,则选用「映射关系」来描述。原因在于:我们进行「信息推测」时,是为了做决策,需要获得「确定的输出结果」,而非「"既是,又是"的输出结果」,因此,「输入变量」在「输入空间」内的每一个可选取值,都只能「对应」「唯一一个输出取值」,不可以对应两个以上的输出结果,否则会得出矛盾的结论。而「映射关系」就是具有这种约束的「变量间的关系」,即:「输入变量」在「输入空间」的每一个可选取值,都只能「对应」一个「唯一的输出取值」。
例如,"从「大学期末分数」到「是否及格」"的推测中,「输入空间」是「0至100的有理数所构成的集合」,「输出空间」是「"及格"和"不及格"两个元素所构成的集合」。「输入变量」在0至100的每一个取值,都只能对应唯一一个输出取值,要么输出及格,要么输出不及格,如果既对应及格又对应不及格,就相当于没推测。通常,大学的判定规则都是:当输入为0至59时,都对应不及格,而输入为60至100时,都对应及格,因此这是一个映射关系。若是150分满分,那么输入为0-89时,都对应不及格,输入为90至150时,都对应及格,这又是另一个映射关系。
下表展示了自然语言和数学语言的概念对应关系。
自然语言 | 数学语言 |
|---|
思维过程、认知过程 | 从输入到输出的关系(信息推测) |
对象(推测依据) | 输入常量(输入空间的元素) |
对象(推测目标) | 输出常量(输出空间的元素) |
仅对单一情况有效的关系 | 对应关系 |
一个对象和另一个对象的个别关系(一个情况) | 从输入常量到输出常量的对应关系(有序对) |
概念(推测依据) | 输入变量 |
概念(推测目标) | 输出变量 |
推测依据的概念外延 | 输入空间 |
推测目标的概念外延 | 输出空间 |
对一类情况有效的通用关系 | 映射关系 |
一个概念和另一个概念的通用关系(一个知识) | 从输入空间到输出空间的映射关系(模型) |
一个知识的适用范围 | 映射的输入空间 |
可拆分成多个子概念的概念 | 多维向量 |
想必会有人疑惑,学习「变量」「空间」「映射」等概念有什么用?
请回想开篇对于描述「思维过程」和「知识」时所遇到的障碍。有了这些数学概念,我们就可以更加清晰明确地描述「思维过程」和「知识」了。
首先,任何「思维过程」都可以被我们用「信息推测(信息加工)」过程来描述,也就是「从输入到输出的推测(加工)过程」。
「输入」是「思维过程的起点」,也是「推测的依据」。
「输出」是「思维过程的终点」,也是「推测的目标」。
我们可以把"从「一个输入常量」到「一个输出常量」的「对应关系」"称为"一个情况"。
然后,我们再把「情况」根据「是否已见」划分为两个子类,即「已见情况」和「未见情况」。这样,我们就可以更清晰地描述「经验」了,也就是「已见情况」。
至于「知识」,我们之前只能粗略地描述为:"从一类事物到另一类事物的通用关系"或"多个情况之间的共有关系"。然而,这些描述仍不能清晰说明知识的适用范围和作用。
现在,我们有了更好的描述方式:
在「一个信息推测(任务)」中,我们通常依靠记忆和回忆「已见情况(经验)」,来根据输入推测输出,也就是「经验推测」。但我们也可以建构出一些「通用规律」。如果某个「通用规律」不仅能推测「已见情况(经验)的输入该对应什么输出」,还能推测「未见情况的输入该对应什么输出」,那么这个「通用规律」就是该「信息推测」下的一个「知识」。
这里有几个要点:
知识总是属于某个「信息推测(任务)」的,但一个信息推测中,可以建构出多个知识。
若用数学语言描述:
「知识」是在一个「信息推测」中,对「所有输入变量的取值」都能推测出「正确输出对应」的「映射关系」。
「知识的适用范围」就是「其输入变量的取值范围」,也就是「它的输入空间」。
「知识的作用」是帮助我们推测未见情况。
需要注意的是:在描述一个「知识」时,不能只说它的「映射关系」,必须要说明这个「映射关系」是"从哪个变量到哪个变量的映射关系"。换句话说,需要「输入空间」「输出空间」「映射关系」三个要素,才能完整描述一个知识。
举例来说,牛顿第一定律(惯性定律)是一个知识,属于"从「受外力为零的物体」到「物体的加速度」的推测规律"。
该知识的「输入空间」是「所有受外力为零的物体组成的集合」,元素可以是「在桌面上受重力和桌面支持力的苹果」或「不受摩擦阻力的滚动的小球」等。
该知识的「输出空间」是「所有物体的加速度组成的集合」,元素可以是「」「」等。
该知识的「映射关系」是"「所有受外力为零的物体」都对应「加速度为零(静止或匀速直线运动)」"。
该知识的「适用范围」是「所有受外力为零的物体组成的集合」。
又如,阿基米德定律(浮力定律)是一个知识,属于"从「浸入液体的物体」到「物体受到的浮力」的推测规律"。
它的「输入空间」是「所有浸入液体的物体所构成的集合」,元素可以是「部分浸入水中的木块」或「完全浸入油中的铁球」等。
它的「输入」可以分成两个维度,即「侵入液体的体积」和「液体的密度」。
它的「适用范围」是「所有浸入液体的物体所构成的集合」。
可以发现,「知识的输入空间」表达了「知识的适用范围」,而「知识的输出空间」表达了「预测目标」,能让我们明白「该知识可以告诉我们什么信息」。
如果一个人在学习某个知识时,不清楚这个知识的输入空间,他就不知道该知识在什么情况下有效,什么情况下无效。如果不清楚知识的输出空间,他就无法判断何时能用上该知识。
因此,我们可以得到「学习的第一原则」:学习任何知识时,都要先明确该知识的输入空间和输出空间,简称"明确输入输出"。
不过,上面只讲了「如何描述」,但要「依靠什么明确」呢?
请针对「牛顿万有引力」回答以下问题:
请针对「光的反射定律」回答以下问题:
BGM:"Within Our Nature" by Scott Buckley is licensed under CC BY 4.0

